Table of Contents
TypeSafe AIのJevがv1.14で多言語対応を強化したというので、ミルクボーイのコーンフレーク漫才で日本語の判定精度を試した話。
なお、この記事には生成AIの出力が含まれる。
Jevとは
JevはTypeSafe AIが提供している意思決定モデル。
普通のLLMと違って、Jevは文章を生成しない。 代わりに、入力として評価対象となるテキストや画像(state)と、型の決まった質問(questions)を受け取って、質問ごとに確率付きの構造化された答えを返す。
JevはLLMのように自然言語や画像を理解できる柔軟性や汎用性を持ちつつ、生成をせずに意思決定に特化することで、GPTやClaudeのようなLLMより数十倍から百倍ほど安く、数十倍速く応答を返すことができる。 生成しないのでハルシネーションの心配は無く、応答が型安全なのでエージェントプログラムで処理しやすいのも利点。
質問の型は今のところ以下の4つ:
- Choice: 与えられた選択肢から1つを選ぶ。選ばれた選択肢と、各選択肢の確率を返す。
- Score: 定義された複数のレベルのなかで、どのくらいの位置づけになるかを返す。
- Noul: yes/noの質問。yesである確率を返す。
- Box: 画像の中で指示されたものの位置を、バウンディングボックスで返す。
1リクエストに複数の質問を入れることができ、各質問を同じstateに対してお互い独立に同時に評価させることができる。
Jev 1.14
Jev v1.14は2026年10月14日にリリースされたバージョン。 changelogに書いてある変更点は以下。
- state、instructions、criteriaに画像を入れられるようになった
- Box質問の追加
- ロングコンテキスト用のヘッダーで、コンテキスト長の上限が262kトークンにできるようになった
- 多言語対応の改善
今回注目するのは多言語対応改善。 日本語のstateや質問に対して、v1.13とv1.14でどれくらい精度が変わるかが気になった。
コーンフレーク判定器
検証の題材に選んだのは、ミルクボーイのコーンフレーク漫才。
Jevをエンジンにして、おかんが好きな朝ごはんの特徴を入力すると、それがコーンフレークであることが十分に確からしければ「コーンフレークやないかい」を、そうでなければ「ほなコーンフレークと違うかぁ」を出力する判定器を書いた。
作った判定器はkaitoy/jev-milkboyに置いた。
判定器の中枢では、TypeSafe AI公式のPython SDKでNoul型の質問を投げている。
from typesafe_sdk import AsyncTypeSafeClient, Noul

QUESTION = "cornflakes"
INSTRUCTIONS = (
    "このセリフが説明している特徴は、コーンフレークに当てはまりますか?"
)
CRITERIA = {
    "true": "セリフの特徴がコーンフレークに当てはまる。",
    "false": "セリフの特徴はコーンフレークには当てはまらない(他の食べ物の特徴など)。",
}


async def judge(client: AsyncTypeSafeClient, line: str, model: str) -> Judgement:
    response = await client.system_one(  # ここでJevにNoulクエリを投げる
        state=line,
        questions={QUESTION: Noul(instructions=INSTRUCTIONS, criteria=CRITERIA)},
        model=model,
    )
    return Judgement(
        probability=response.nouls[QUESTION].noul,  # これが質問の回答
        model=response.model,
        input_tokens=response.usage.input_tokens,
    )

# (snip)Noul型の質問の回答には、答えがyesである確率が0から1の値で入っている。
質問は「このセリフが説明している特徴は、コーンフレークに当てはまりますか?」なので、入力したセリフがコーンフレークのことを言っている確率を出してくれるということになる。
だいたい、0.7以上であればyes、0.3以下であればno、その中間だと自信なしというのが目安らしいけど、今回は0.5以上ならコーンフレークということにする。
Jev 1.13 vs 1.14
この判定器をJev 1.13と1.14で実行してみる。
Jev 1.13での実行結果:
$ uv run jev-milkboy lines.txt --model jev-1.13.0
駒場: 甘くてカリカリしてて牛乳とかかけて食べるやつやって言うねんな
内海: コーンフレークやないかい (yes 0.84)

駒場: おかんが言うには死ぬ前の最後のご飯もそれでいいって言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.25)

駒場: なんであんなに栄養バランスの五角形でかいんかわからんらしいねん。
内海: ほなコーンフレークと違うかぁ (yes 0.33)

駒場: おかんが言うには晩ごはんで出てきても全然いいて言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.40)

駒場: 子供の頃、なぜかみんな憧れたらしい
内海: ほなコーンフレークと違うかぁ (yes 0.30)

駒場: おかんが言うにはお坊さんの修行の時も食べてるって言うてて
内海: ほなコーンフレークと違うかぁ (yes 0.15)

駒場: パフェとかの重増しに使われてるらしいねん
内海: ほなコーンフレークと違うかぁ (yes 0.43)

駒場: おかんが言うにはジャンルで言うと中華て言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.09)

駒場: 食べてる時に誰に感謝していいかわからんらしいねん
内海: ほなコーンフレークと違うかぁ (yes 0.17)

判定: 9/9  コーンフレークやないかい: 1  ほなコーンフレークと違うかぁ: 8  エラー: 0  モデル: jev-1.13.0  入力トークン: 3573
意外とv1.13でも日本語理解してそう。
甘くてカリカリしてるのはコーンフレークで、中華はコーンフレークじゃないことをしっかり理解している。
けど全体的にno判定が多く、正解率は低い。
Jev 1.14での実行結果:
$ uv run jev-milkboy lines.txt
駒場: 甘くてカリカリしてて牛乳とかかけて食べるやつやって言うねんな
内海: コーンフレークやないかい (yes 0.83)

駒場: おかんが言うには死ぬ前の最後のご飯もそれでいいって言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.27)

駒場: なんであんなに栄養バランスの五角形でかいんかわからんらしいねん。
内海: ほなコーンフレークと違うかぁ (yes 0.35)

駒場: おかんが言うには晩ごはんで出てきても全然いいて言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.33)

駒場: 子供の頃、なぜかみんな憧れたらしい
内海: ほなコーンフレークと違うかぁ (yes 0.31)

駒場: おかんが言うにはお坊さんの修行の時も食べてるって言うてて
内海: ほなコーンフレークと違うかぁ (yes 0.16)

駒場: パフェとかの重増しに使われてるらしいねん
内海: ほなコーンフレークと違うかぁ (yes 0.29)

駒場: おかんが言うにはジャンルで言うと中華て言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.10)

駒場: 食べてる時に誰に感謝していいかわからんらしいねん
内海: ほなコーンフレークと違うかぁ (yes 0.24)

判定: 9/9  コーンフレークやないかい: 1  ほなコーンフレークと違うかぁ: 8  エラー: 0  モデル: jev-1.14.0  入力トークン: 3573
残念ながら、v1.14で実行しても結果はほとんど変わらなかった。 むしろちょっと悪化した感すらある。
stateにコーンフレークの概要を追加
v1.14の多言語強化については実感できなかったけど、せっかくなので、判定器のチューニングをして正解率を上げていきたい。
Jevの日本語能力は十分にあるようなので、足りないのはコーンフレークの知識ではないかと思い、ケロッグのサイトからGeminiでコーンフレークの知識を抽出し、Jevへのクエリのstateに入れてみた。
JevのstateにはJSONオブジェクトを渡せるので、駒場のセリフとコーンフレーク情報を構造化して詰めることができる。
CORNFLAKES_KNOWLEDGE = (
    "ケロッグのコーンフレークは、厳選された自然の恵みのコーンを独自の製法で香ばしく焼き上げた、"
    "甘くないロングセラーのシリアルです。1食(40g)あたりで6種類のビタミンと鉄分をバランスよく摂ることができ、"
    "栄養機能食品(鉄)としても認められています。そのまま食べるのはもちろん、"
    "牛乳をかけて手軽に栄養のある朝食を楽しめるのが特徴です。"
)

# (snip)

    response = await client.system_one(
        state={"line": line, "cornflakes_knowledge": CORNFLAKES_KNOWLEDGE}, # 構造化state
        questions={QUESTION: Noul(instructions=INSTRUCTIONS, criteria=CRITERIA)},
        model=model,
    )

# (snip)
これで実行した結果:
$ uv run jev-milkboy lines.txt
駒場: 甘くてカリカリしてて牛乳とかかけて食べるやつやって言うねんな
内海: ほなコーンフレークと違うかぁ (yes 0.23)

駒場: おかんが言うには死ぬ前の最後のご飯もそれでいいって言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.26)

駒場: なんであんなに栄養バランスの五角形でかいんかわからんらしいねん。
内海: ほなコーンフレークと違うかぁ (yes 0.28)

駒場: おかんが言うには晩ごはんで出てきても全然いいて言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.11)

駒場: 子供の頃、なぜかみんな憧れたらしい
内海: ほなコーンフレークと違うかぁ (yes 0.17)

駒場: おかんが言うにはお坊さんの修行の時も食べてるって言うてて
内海: ほなコーンフレークと違うかぁ (yes 0.08)

駒場: パフェとかの重増しに使われてるらしいねん
内海: ほなコーンフレークと違うかぁ (yes 0.26)

駒場: おかんが言うにはジャンルで言うと中華て言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.05)

駒場: 食べてる時に誰に感謝していいかわからんらしいねん
内海: ほなコーンフレークと違うかぁ (yes 0.11)

判定: 9/9  コーンフレークやないかい: 0  ほなコーンフレークと違うかぁ: 9  エラー: 0  モデル: jev-1.14.0  入力トークン: 5265
悪化した。 あれだけ自信もって正解していた「甘くてカリカリ」がコーンフレークと違うかぁになってしまった。 コーンフレーク判定が0件になってしまったので、正解率100%に向けて5件まで増やさないといけない。
よく見なおしたら、追加したコーンフレーク情報に「甘くないロングセラーのシリアル」とあるので、それに忠実に従った結果でJevは悪くない。
stateのコーンフロスティ化
つまり、ミルクボーイが話しているのは、厳密にはコーンフレークではないということだ。 甘くて、虎が腕組みしているということは、殊更にケロッグのコーンフロスティについて言及していることになる。
コーンフレーク漫才ではなく、コーンフロスティ漫才。 この違いに気付けたのはよかった。
Geminiにケロッグのサイトからコーンフロスティの説明を作ってもらい、判定器を改善した。
CORNFLAKES_KNOWLEDGE = (
    "ケロッグのコーンフレークは、トラのキャラクター「トニー・ザ・タイガー」でもおなじみの、"
    "世界中で愛されている砂糖がけのコーンフレークです。厳選したとうもろこしの粒を香ばしく焼き上げ、"
    "ほどよい砂糖をまぶしたサクサク食感のフレークに仕上げています。"
    "学校給食摂取基準に準拠したビタミンやミネラルなどの栄養バランスも満たしており、"
    "牛乳をかけるだけで手軽に美味しくエネルギーチャージができるシリアルです。"
)
実行結果は以下:
$ uv run jev-milkboy lines.txt
駒場: 甘くてカリカリしてて牛乳とかかけて食べるやつやって言うねんな
内海: コーンフレークやないかい (yes 0.91)

駒場: おかんが言うには死ぬ前の最後のご飯もそれでいいって言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.24)

駒場: なんであんなに栄養バランスの五角形でかいんかわからんらしいねん。
内海: ほなコーンフレークと違うかぁ (yes 0.34)

駒場: おかんが言うには晩ごはんで出てきても全然いいて言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.15)

駒場: 子供の頃、なぜかみんな憧れたらしい
内海: ほなコーンフレークと違うかぁ (yes 0.31)

駒場: おかんが言うにはお坊さんの修行の時も食べてるって言うてて
内海: ほなコーンフレークと違うかぁ (yes 0.10)

駒場: パフェとかの重増しに使われてるらしいねん
内海: ほなコーンフレークと違うかぁ (yes 0.25)

駒場: おかんが言うにはジャンルで言うと中華て言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.06)

駒場: 食べてる時に誰に感謝していいかわからんらしいねん
内海: ほなコーンフレークと違うかぁ (yes 0.15)

判定: 9/9  コーンフレークやないかい: 1  ほなコーンフレークと違うかぁ: 8  エラー: 0  モデル: jev-1.14.0  入力トークン: 5544
甘くてカリカリは0.91まで回復したが、正解率としては振り出しに戻っただけ。
stateに栄養バランスがいいと書いたのに、「栄養バランスの五角形でかい」というセリフがコーンフレーク判定されないのは、五角形でかいという駒場の独特な言い回しが栄養バランスに結び付いていないからか。
stateにコーンフロスティのパッケージ画像を追加
Jev 1.14は画像入力にも対応したので、五角形でかいを理解させるためにケロッグのサイトにあったコーンフロスティのパッケージ画像をstateにいれてみる。
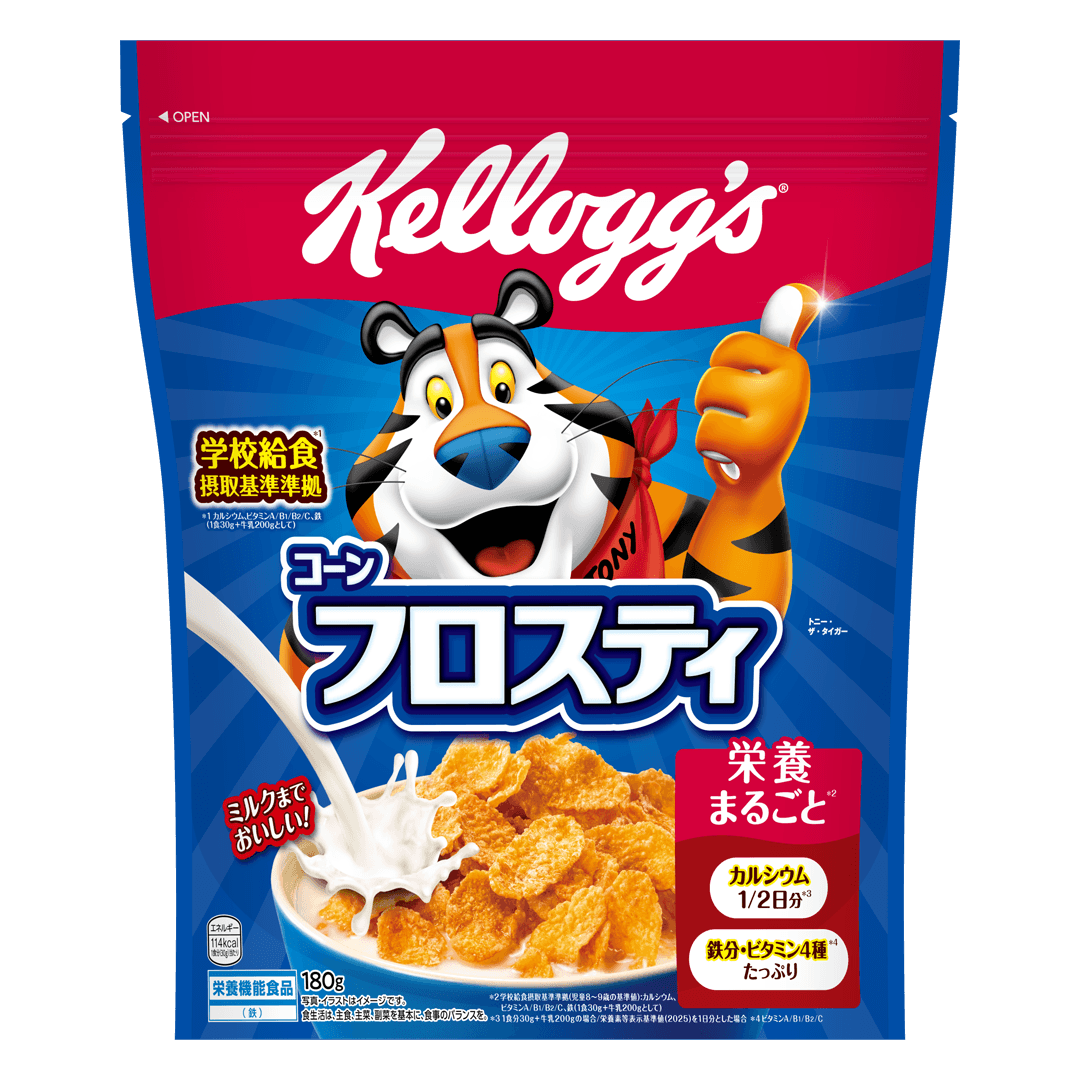
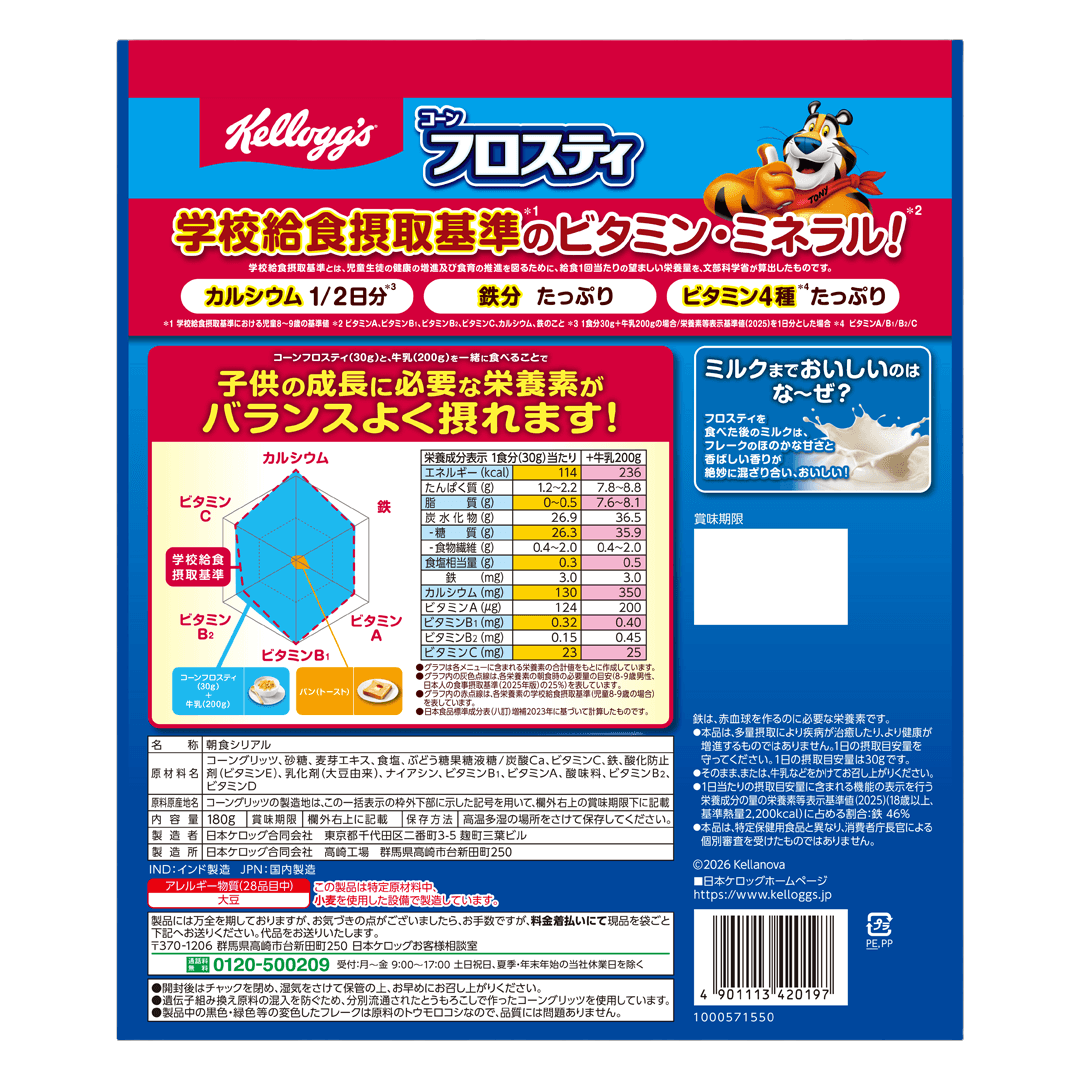
(画像の出典: 日本ケロッグ)
よくみると六角形なんだけど、これで伝わるだろうか。
画像はImageでファイルパスを指定してstateに入れるだけで渡せる。
from pathlib import Path

from typesafe_sdk import AsyncTypeSafeClient, Image, Noul

PACKAGE_DIR = Path(__file__).parent
CORNFLAKES_FRONT = Image(PACKAGE_DIR / "front.png") # パッケージ表画像
CORNFLAKES_BACK = Image(PACKAGE_DIR / "back.png")   # パッケージ裏画像
# Jev rejects requests that contain images unless this header is sent.
IMAGES_HEADERS = {"TypeSafe-Danger-Zone-Images": "true"}

# (snip)

    response = await client.system_one(
        state={
            "line": line,
            "cornflakes_knowledge": CORNFLAKES_KNOWLEDGE,
            "cornflakes_package_front": CORNFLAKES_FRONT, # パッケージ表画像
            "cornflakes_package_back": CORNFLAKES_BACK,   # パッケージ裏画像
        },
        questions={QUESTION: Noul(instructions=INSTRUCTIONS, criteria=CRITERIA)},
        model=model,
        extra_headers=IMAGES_HEADERS,
    )
これで実行した結果は以下:
$ uv run jev-milkboy lines.txt
駒場: 甘くてカリカリしてて牛乳とかかけて食べるやつやって言うねんな
内海: コーンフレークやないかい (yes 0.87)

駒場: おかんが言うには死ぬ前の最後のご飯もそれでいいって言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.32)

駒場: なんであんなに栄養バランスの五角形でかいんかわからんらしいねん。
内海: コーンフレークやないかい (yes 0.61)

駒場: おかんが言うには晩ごはんで出てきても全然いいて言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.28)

駒場: 子供の頃、なぜかみんな憧れたらしい
内海: コーンフレークやないかい (yes 0.61)

駒場: おかんが言うにはお坊さんの修行の時も食べてるって言うてて
内海: ほなコーンフレークと違うかぁ (yes 0.17)

駒場: パフェとかの重増しに使われてるらしいねん
内海: ほなコーンフレークと違うかぁ (yes 0.36)

駒場: おかんが言うにはジャンルで言うと中華て言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.09)

駒場: 食べてる時に誰に感謝していいかわからんらしいねん
内海: ほなコーンフレークと違うかぁ (yes 0.27)

判定: 9/9  コーンフレークやないかい: 3  ほなコーンフレークと違うかぁ: 6  エラー: 0  モデル: jev-1.14.0  入力トークン: 61119
狙い通り五角形がコーンフレーク判定になった。 ついでになぜか子供のあこがれもコーンフレーク判定になった。トニー・ザ・タイガーがヒーローっぽいから?
ちなみに、画像を入れたことで入力トークンが5,544から61,119に10倍以上増えた。 100万トークンあたり$0.042なので、それでも0.4円にしかならない。
stateにコーンフロスティのレシピを追加
パフェの重増しがコーンフレーク判定されないのはどうするか。
ケロッグのサイトを見返していたら、コーンフロスティのレシピ集が載っていて、そこにパフェがあるのに気付いた。これはありがたい。
サイトに載ってるレシピの名前と概要の一覧をClaude Coworkに作ってもらってstateに入れた。
CORNFLAKES_RECIPES = (
    "コーンフロスティ フレンチトースト:卵液でふやかしたフロスティをバターで焼き、フルーツと粉砂糖で仕上げるフレンチトースト風。",
    "コーンフロスティの野菜もち:かぼちゃ・すりおろし人参・片栗粉と砕いたフロスティを混ぜて焼く、野菜嫌いの子にも食べやすいおやき。",
    "コーンフロスティアイスクリーム:バニラアイスにフロスティをのせ、いちごとミントを添えるだけの5分デザート。",
    "コーンフロスティヨーグルトパフェ:ヨーグルトにキウイ・バナナ・ブルーベリーとフロスティを重ねたフルーツたっぷりのパフェ。",
    "ザクザクかぼちゃグラタン:かぼちゃ・玉ねぎ・ウインナーにチーズとフロスティをのせて焼く、ザクザク食感のグラタン。",
    # (snip)
)

# (snip)

        state={
            "line": line,
            "cornflakes_knowledge": CORNFLAKES_KNOWLEDGE,
            "cornflakes_recipes": list(CORNFLAKES_RECIPES), # コーンフロスティレシピ
            "cornflakes_package_front": CORNFLAKES_FRONT,
            "cornflakes_package_back": CORNFLAKES_BACK,
        },

# (snip)
これで実行した結果は以下:
$ uv run jev-milkboy lines.txt
駒場: 甘くてカリカリしてて牛乳とかかけて食べるやつやって言うねんな
内海: コーンフレークやないかい (yes 0.86)

駒場: おかんが言うには死ぬ前の最後のご飯もそれでいいって言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.40)

駒場: なんであんなに栄養バランスの五角形でかいんかわからんらしいねん。
内海: コーンフレークやないかい (yes 0.60)

駒場: おかんが言うには晩ごはんで出てきても全然いいて言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.34)

駒場: 子供の頃、なぜかみんな憧れたらしい
内海: コーンフレークやないかい (yes 0.64)

駒場: おかんが言うにはお坊さんの修行の時も食べてるって言うてて
内海: ほなコーンフレークと違うかぁ (yes 0.24)

駒場: パフェとかの重増しに使われてるらしいねん
内海: コーンフレークやないかい (yes 0.73)

駒場: おかんが言うにはジャンルで言うと中華て言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.11)

駒場: 食べてる時に誰に感謝していいかわからんらしいねん
内海: ほなコーンフレークと違うかぁ (yes 0.30)

判定: 9/9  コーンフレークやないかい: 4  ほなコーンフレークと違うかぁ: 5  エラー: 0  モデル: jev-1.14.0  入力トークン: 68490
思った通りパフェの重増しが0.73まで上がった。
一方で、死ぬ前の最後のご飯が0.32から0.40に、晩ごはんで出てきてもいいが0.28から0.34に上がってしまった。 0.5は超えていないからいいけど、おかず系のレシピも教えたせいで、コーンフレークが晩ごはんに出てきてもおかしくないとJevが思い始めたっぽい。
セリフに虎の顔を追加
最後に残ったのが「食べてる時に誰に感謝していいかわからんらしいねん」。
もとのネタでは、内海がこれに「浮かんでくるのは腕組んでる虎の顔だけやねん」と返す。 つまり、コーンフレークを食べるときに浮かんでくるのは生産者の顔ではなくトニー・ザ・タイガーの顔だ、ということなんだけど、ちょっとハイコンテクストが過ぎる。
これはstateのチューニングで頑張るのは断念。
反則気味だけど、セリフのほうをいじることにする。
内海のツッコミの一部を駒場のセリフにくっつけて、以下のようにした。
食べてる時に誰に感謝していいかわからんらしいねん。浮かんでくるのは腕組んでる虎の顔だけやねん
これで正答率100%になった。
 uv run jev-milkboy lines.txt
駒場: 甘くてカリカリしてて牛乳とかかけて食べるやつやって言うねんな
内海: コーンフレークやないかい (yes 0.88)

駒場: おかんが言うには死ぬ前の最後のご飯もそれでいいって言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.36)

駒場: なんであんなに栄養バランスの五角形でかいんかわからんらしいねん。
内海: コーンフレークやないかい (yes 0.57)

駒場: おかんが言うには晩ごはんで出てきても全然いいて言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.36)

駒場: 子供の頃、なぜかみんな憧れたらしい
内海: コーンフレークやないかい (yes 0.65)

駒場: おかんが言うにはお坊さんの修行の時も食べてるって言うてて
内海: ほなコーンフレークと違うかぁ (yes 0.17)

駒場: パフェとかの重増しに使われてるらしいねん
内海: コーンフレークやないかい (yes 0.73)

駒場: おかんが言うにはジャンルで言うと中華て言うねん
内海: ほなコーンフレークと違うかぁ (yes 0.11)

駒場: 食べてる時に誰に感謝していいかわからんらしいねん。浮かんでくるのは腕組んでる虎の顔だけやねん
内海: コーンフレークやないかい (yes 0.81)

判定: 9/9  コーンフレークやないかい: 5  ほなコーンフレークと違うかぁ: 4  エラー: 0  モデル: jev-1.14.0  入力トークン: 68467
まとめ
Jev 1.14の日本語力を試すために、ミルクボーイのコーンフレーク漫才の判定器を作った。
実行してみた結果、v1.14での多言語対応の改善は今回のコーンフレーク判定器では効果が見えなかった。 v1.13でも関西弁のセリフをそれなりに理解しているようで、v1.14との差はほとんどなく、いずれも正解率は低かった。
正解率が低かったのは日本語が読めないからではなく、判定に要する知識が足りないからだった。
Jevの判定はstateに入れた情報に大きく影響される。
stateに甘くないと書けば甘いものを否定するし、パッケージを見せれば栄養バランスのセリフの意図を察するし、おかずのレシピを入れれば晩ごはんにコーンフレークを受け入れる。
LLMのプロンプトチューニングに近いけど、Jevの場合は質問に情報を足すことはせず、stateにいれる情報をチューニングする。
Jevのマニュアルにも、
stateにはモデルに評価・分析してもらうための元データや背景となる事実をいれて、questionsにはそのstateに対してモデルが下すべき判断や評価、抽出の基準判断を書いて、両者をしっかり分離しろ、とある。
Jevを使ったアプリでは、そこを意識した設計が大事ということが学べた。
